Worksheet 8
作業系統讓每個 process 都以為自己擁有整台電腦的記憶體,但實際上,許多 process 共用同一塊 DRAM。這週就來看看這層間接(indirection)是怎麼運作的:把每個位址對應到 RAM 的 page table、負責寫入它的 kernel、照著它查表的 MMU(CPU 裡負責位址轉換的硬體),以及讓這一切變快的 TLB。這些正是 xv6 Lab 2 需要的知識。 請讀完這份 worksheet,並用最後的 self-check 準備下一次小考。 想讀英文原文?試試 English 版!
💸 記憶體從來都很貴。1953 vs 2026 (點開來看)
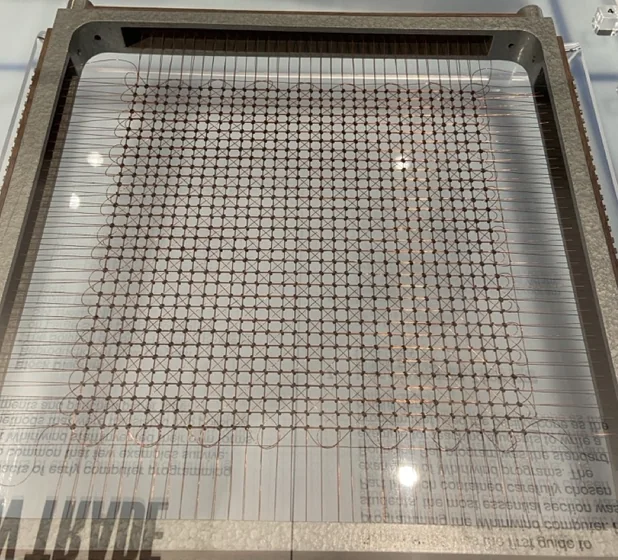
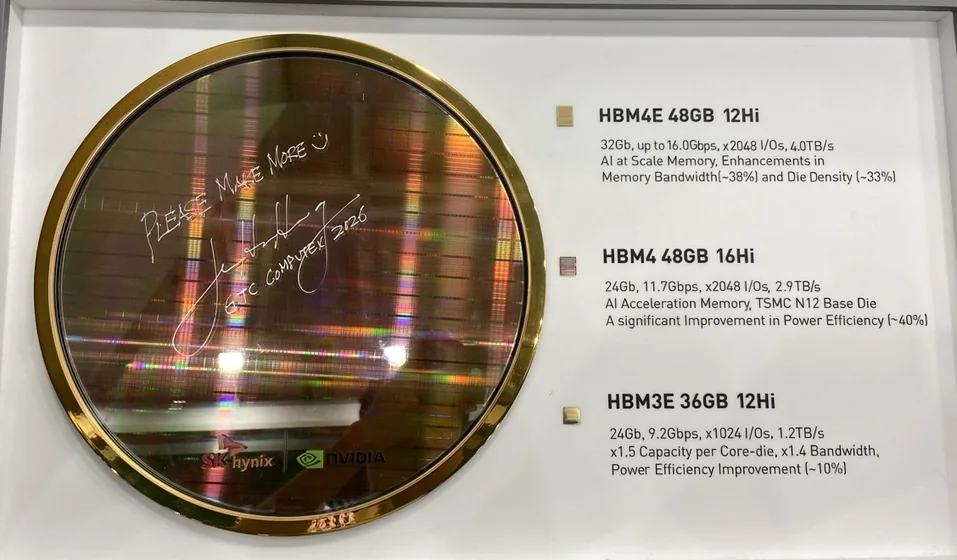
記憶體永遠不夠用。所以作業系統才要這麼小心地分配它。
Part 1一個位址,兩個值
這是一個很小的 C 程式。它把第一個參數存進全域變數 counter,接著每秒印出一次這個變數的位址和值,總共印三次。
int counter = 0;

int main(int argc, char **argv) {
    counter = atoi(argv[1]);
    for (int i = 0; i < 3; i++) {
        printf("[pid %d] &counter = %p, counter = %d\n", getpid(), (void *)&counter, counter);
        sleep(1);
    }
}
我把它編譯成固定位址的執行檔(gcc -no-pie),所以每一份執行中的程式都把 counter 放在同一個 virtual address。然後我同時啟動兩份:
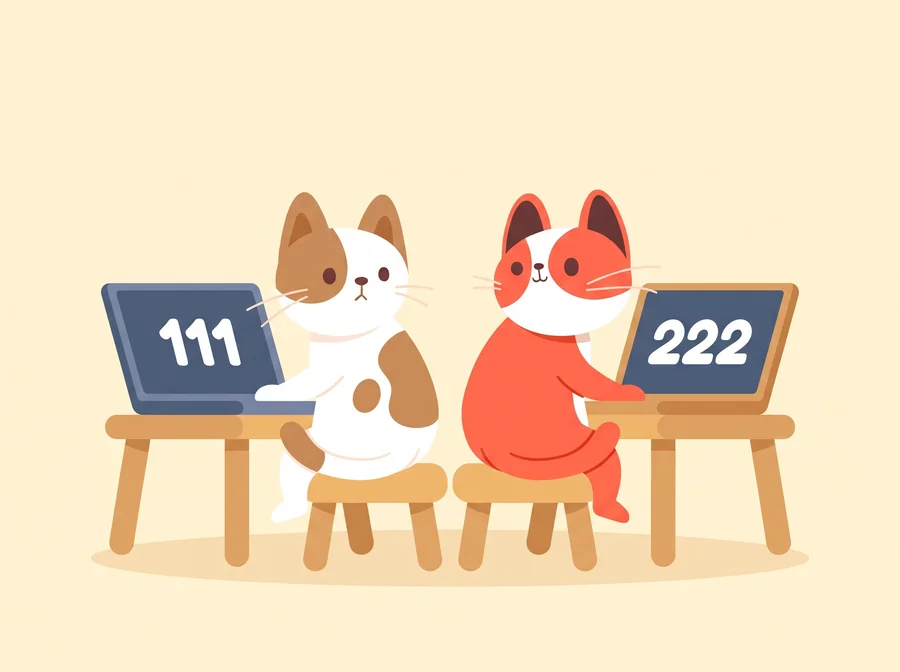
$ ./same 111 & ./same 222
[pid 1783045] &counter = 0x404044, counter = 111   ← process A
[pid 1783046] &counter = 0x404044, counter = 222   ← process B
[pid 1783045] &counter = 0x404044, counter = 111
[pid 1783046] &counter = 0x404044, counter = 222
[pid 1783046] &counter = 0x404044, counter = 222
[pid 1783045] &counter = 0x404044, counter = 111
兩者印出的位址都是 0x404044,但 process A 在那裡讀到 111,process B 卻讀到 222。RAM 裡的同一個位置不可能同時存著兩個值。所以同一個 virtual address 會通往 RAM 裡兩個不同的位置,每個 process 各一個:
0x404044:各自被轉換到 RAM 裡不同的位置。其他區域也同樣散落在各處。每一次讀取(load)、寫入(store)和取指令(instruction fetch),硬體都會把 virtual address 轉換成 physical address,也就是 RAM 裡真正的位置,而且每個 process 的轉換方式都不一樣。好的位址轉換機制有三個目標:
- 透明性(Transparency)。不論資料放在 RAM 的哪裡,程式的行為都一樣。程式完全不需要知道資料在哪。
- 保護(Protection)。一個 process 只能使用 map 給它的記憶體,而且只能用它的權限允許的方式使用。B 的私有記憶體和 kernel 的記憶體,A 都碰不到。
- 效率(Efficiency)。雖然每次存取記憶體都要轉換,但轉換只花很少的時間和很少的記憶體。
Part 2最簡單的機制:每個 process 一個區塊
在看真實系統怎麼做之前,先想想最簡單的機制:每個 process 分到 RAM 裡的一個區塊。假設 process A 的區塊從 320 KB 開始,長度是 64 KB。硬體把 A 使用的每個位址都加上 320 KB,並拒絕任何大於或等於 64 KB 的位址。每個 process 只需要兩個數字,一個起點和一個長度:
現在來看一個真實的 process。在我的 x86-64 Linux 電腦上,一個 process 可以使用從 0 到 247(不含)的 virtual address,範圍有 128 TiB。Linux 會在 /proc/self/maps 列出一個 process 用到哪些部分,這是 kernel 替每個 process 產生的檔案。
每一行是一個區域(region):起始位址、結束位址(區域結束之後的第一個 byte)、權限,以及它來自哪個檔案。r、w 和 x 分別代表 read、write 和 execute。p 表示對這個區域的修改只留在這個 process 裡,不會被別人看到(沒有人修改過的 page 仍然可以共用)。libc 是 C 函式庫。以下是精簡過的 map:
5a8166aba000-5a8166abb000 r-xp  /home/me/where  ← code5a8166abc000-5a8166abd000 r--p  /home/me/where  ← constants5a8166abd000-5a8166abe000 rw-p  /home/me/where  ← globals, counter5a819dd7d000-5a819dd9e000 rw-p  [heap]  ← heap
7bfedd828000-7bfedd9b1000 r-xp  /usr/lib/x86_64-linux-gnu/libc.so.6  ← libc code, shared7bfedda04000-7bfedda06000 rw-p  /usr/lib/x86_64-linux-gnu/libc.so.6  ← libc globals
7ffd81640000-7ffd81661000 rw-p  [stack]  ← stack
單一個 RAM 區塊沒辦法好好容納這些區域,因為有五種情況要考慮:
- 空隙非常大。在 heap(
0x5a81…)和 libc(0x7bfe…)之間,有超過 30 TiB 的位址沒有通往任何地方。如果只用一個區塊,就得替這些位址全部準備 RAM。 - 每個區域的權限不同。Code 可以執行,但不能修改。Data 可以修改,但不能執行。一個區塊只有一組權限。
- 區域會長大。heap 往上長,stack 往下長。一個區塊如果在 RAM 裡撞上隔壁的區塊,就得搬家,而搬家代表要把整個區塊複製一遍。
- 有些記憶體是共用的。幾乎每個 process 都會 map libc 的 code。RAM 裡應該只放一份,供所有 process 使用。
- 空閒的 RAM 會碎成一個個洞。隨著程式啟動又結束,區塊之間的空閒空間大小不一。新程式可能塞不進任何一個洞,即使空閒 RAM 的總量其實足夠。這就是 external fragmentation。
Paging 讓記憶體不必是一整塊:它以 4 KiB 的 page 為單位來 map 記憶體,每個 page 各自獨立。這樣一來,沒用到的空隙不需要任何 RAM 的 frame,而變大的 heap 或 stack 只要再多拿一個 page 就好,RAM 哪裡有空位都行。因為所有 page 大小都一樣,RAM 裡任何一個空閒的 page 都放得下任何程式的任何一個 page,所以不會出現大小不一的洞。不同的 page 也可以有不同的權限:code 的 page 可以是唯讀,data 的 page 可以寫入,而且好幾個 process 可以 map libc code 的同一個唯讀 page。
不過,因為記憶體以 4 KiB 為單位來分配,一個區域的最後一個 page 通常只用到一部分。一個從 page 邊界開始、大小 4097 bytes 的區域會佔用兩個 page,也就是 8192 bytes,其中 4095 bytes 沒有用到。這種 page 內部的浪費稱為 internal fragmentation。對一個從 page 邊界開始的區域來說,這種浪費一定少於一個 page。
Part 3Page 與 page table
Paging 把 virtual address space 和實體 RAM 都切成同樣大小的單位。xv6 的一般 page,以及這裡所有的例子,大小都是 4 KiB(4096 bytes):
- Virtual address space 被切成一個個 page。
- 實體 RAM 被切成同樣大小的 frame(也叫做 physical page)。
- 每個 process 都有一個 page table,把自己每個正在使用的 page 對應到一個 frame。
位址轉換以整個 page 為單位。它把 page number 換成 frame number,並保留這個 byte 在 page 裡的位置,也就是 offset。過程中沒有複製任何資料:位址轉換只決定一個位址指的是哪個 frame。
因為 4096 = 212,offset 剛好是位址的最低 12 個 bit,也就是最後三個十六進位數字。位址剩下的部分是 virtual page number(VPN)。以 counter 為例:它的位址是 4,210,756(0x404044)= 1028 × 4096 + 68,所以它是 byte 68,位在 page 1028。Process A 的 page table 把 page 1028 對應到 frame 37,所以 physical address 是 frame 37 的 byte 68:37 × 4096 + 68 = 151,620。
0x404044 是 page 1028(0x404)的 byte 68(0x044):最後三個十六進位數字前面的所有部分就是 page number。① 用 page number 查 process A 的 page table。② 查到的 entry 給出 frame。③ Offset 原封不動地複製過去。Process B 的 page table 把同一個 page 1028 對應到另一個 frame:這就是兩份 same 分別看到 111 和 222 的原因。誰寫 page table?誰使用它?
使用者程式永遠無法存取自己的 page table。讀取或更新 page table 的是 kernel 和 MMU:
- Kernel 負責寫每個 process 的 page table,由它決定一個 process 拿到哪些 frame。
- MMU(memory management unit,記憶體管理單元)是 CPU 的一部分。它用正在執行的 process 的 page table 來轉換每一次 load、store 和取指令,完全不需要 kernel 幫忙。
Kernel 會在程式執行期間修改 page table,例如 heap 變大時,再多映射一個 page。
Part 4單一大表太大了:改用樹狀結構
最簡單的 page table 是一個大陣列,每個 virtual page 對應一個 entry,每個 entry 8 bytes。這個陣列有多大?
- xv6 跑在使用 Sv39 的 RISC-V 上:位址只有低 39 個 bit 會被轉換。(指標仍然是 64 bits,但最高的 25 個 bit 必須全部和 bit 38 相同。)扣掉 12 bit 的 offset,page number 還剩 27 bits:227 個 page × 8 bytes = 每個 process 1 GiB。
- x86-64 使用 48 bit 的位址:236 個 page × 8 bytes = 每個 process 512 GiB。
這大得離譜。🫠 更糟的是,幾乎全部都浪費掉了。真實的程式只會用到幾塊小區域:底部附近的一些程式碼和資料、中間的函式庫、頂端附近的 stack。單層 page table 裡幾乎每個 entry 都會寫著「這裡什麼都沒有」。
解法:樹狀結構
Sv39 把 27 bit 的 page number 切成三個 9 bit 的 index,並使用由小 table 組成的樹。
- 每一層的每張 table 都有 29 = 512 個 entry,每個 8 bytes。512 × 8 = 4096:每張 page table 剛好就是一個 page,所以 kernel 配置它們的方式跟其他 page 完全一樣。
- xv6 的層級是往下數的。level-2 table 就是 root,它的每個 entry 涵蓋 1 GiB(29+9+12 = 230 bytes)的 address space。在這裡使用的 4 KiB page 下,一個 valid 的 root entry 會指向一張 level-1 table。
- 每個 level-1 entry 涵蓋 2 MiB,並指向一張 level-0 table。
- 每個 level-0 entry 涵蓋一個 4 KiB page,存放這個 page 的 frame number。指出資料所在 frame 的那個 entry 叫做 leaf。使用 4 KiB page 時,leaf 一定在 level 0。
這三個 index 是怎麼從 page number 算出來的?0x404044 的 page 1028 = 0 × 512 × 512 + 2 × 512 + 4,所以它的 index 是 0、2 和 4。用二進位來看,就只是把 27 個 bit 切成三組,每組 9 個 bit。
0x404044 被切成 MMU 使用的各個部分。每個十六進位數字代表 4 個 bit。Offset 剛好是最後三個十六進位數字 0x044 = 68。9 bit 的 index 和十六進位數字對不齊,所以要從 bit 讀出來:0、2 和 4。圖中只畫出低 39 個 bit:再往上的 25 個 bit 都重複 bit 38,這裡是 0。如果整塊 1 GiB 的區域都沒有使用,它的 root entry 就直接標成 invalid,而且它下面的 table 全都不存在。這空著的 1 GiB 只花掉一個 8 bytes 的 entry。
Page walk
Page table 並不是放在 CPU 裡某個特殊的地方。Page table 就是 RAM 裡普通的 frame,和它們所映射的資料混在一起。轉換一個位址,就是沿著 RAM 裡的指標一路走下去:root table 指出一張 level-1 table 所在的 frame,那張 table 再指出一張 level-0 table 所在的 frame,最後只有這張 table 會指出資料所在的 frame。每一步都是一次真正的記憶體讀取(CPU 的 cache 可能很快就回應其中幾次,但它們仍然是讀取)。先知道下面幾件事,才看得懂後面的 walk。CPU 暫存器 satp 存放 root table 所在的 frame。每個 entry 中,V = 1 表示這個 entry 是 valid,R = 1 允許讀取,U = 1 允許 user mode 存取。如果某個 entry 不存在,或某項檢查沒通過,CPU 就會觸發 page fault,把控制權交給 kernel。一步一步走過一次 load,並數數看讀了幾次記憶體。
counter。一次讀一次記憶體,MMU 沿著 page table 走,從 satp 出發,經過 RAM 裡的三個 frame 抵達資料,你負責數讀取的次數。接著是兩次 walk 提早停下的 load:一次遇到空的 entry,另一次遇到 U = 0 的 page。途中記得先猜猜看。
開啟 Walkthrough 1 ▶ 11 步 · 用 ← → 鍵切換 · 按 E 看說明
讓樹長大
樹的大小取決於哪些 page 被映射。接下來看看 kernel 怎麼映射下一個 4 KiB page、往上 2 MiB 的一個 page,以及往上 1 GiB 的一個 page。
開啟 Walkthrough 2 ▶ 7 步 · 用 ← → 鍵切換 · 按 E 看說明
Part 5page-table entry 裡寫了什麼
page table 裡的一個項目叫做 page-table entry(PTE)。一個 PTE 有 64 個 bit。在 Sv39 中,第 10 到 53 個 bit 存放 physical page number(PPN):指向下一層表格所在的 frame,或者在 leaf 中,指向資料所在的 frame。最低的 8 個 bit 是 flag,MMU 每次存取都會檢查它們。這裡要看的是其中七個。第八個 G(global)xv6 沒有用到,而第 8 和第 9 個 bit 則留給 kernel 自由使用。
| Bit | 名稱 | 為 1 時的意義 | 由誰設定 |
|---|---|---|---|
| V | valid | 這個 entry 有效。如果 V 是 0,MMU 會忽略其他所有 bit:這裡沒有 page。 | kernel |
| R | read | 這個 page 可以讀取。 | kernel |
| W | write | 這個 page 可以寫入。 | kernel |
| X | execute | CPU 可以執行這個 page 裡的指令。 | kernel |
| U | user | user mode 可以使用這個 page。如果 U 是 0,只有 kernel 可以使用。 | kernel |
| A | accessed | 自從這個 bit 上次被清除以來,這個 page 曾被讀取、寫入或執行。 | 硬體 |
| D | dirty | 自從這個 bit 上次被清除以來,這個 page 曾被寫入。 | 硬體 |
U = 0 讓 user mode 碰不到這個 page。MMU 會拒絕 user mode 對它的任何存取。在 xv6 process 的 page table 中,有三個 page 的 U = 0。其中兩個位在最頂端:trampoline 是在程式與 kernel 之間切換的程式碼,trapframe 則存放程式被保存下來的暫存器。第三個是緊鄰 stack 下方的 guard page:stack 長得太大時會碰到它而觸發 fault,而不是悄悄覆寫其他資料。kernel 的其餘部分根本不在 process 的 page table 裡:kernel 使用自己的 page table。
還有一條規則告訴 MMU 什麼時候要繼續往下走。如果 V 是 1,但 R、W、X 全是 0,這個 entry 就不是 page:它指向下一層的表格。每一層都用同樣的 PTE 格式,只有這三個 bit 能分辨它是指標還是 leaf。以下是 MMU 為了 0x404044 讀到的三個 entry:
0x404044 的 page walk 中每一層各一個 PTE,格式都相同(PPN 以上的 bit 以及第 8、9 個 bit 都是 0,圖中沒有畫出)。root table 和 level-1 table 的 entry 只設定了 V,所以它們指向下一層表格。level-0 table 的 entry 設定了 R 和 W:它是 leaf,而 frame 37 存放著 counter。試著設定或清除這些 bit,或直接看看不同種類 page 的 PTE:
xv6 中同樣的 page walk
MMU 用硬體走這棵樹。xv6 也會用軟體走一遍,也就是 kernel/vm.c 裡的 walk(),用來找出某個 user 位址的 level-0 entry。建立 mapping 時需要這個 entry,在 kernel 與 user buffer 之間複製資料時也需要:kernel 使用自己的 page table,所以 copyout() 必須自己查出 user 的 mapping。walk() 用到 kernel/riscv.h 裡的幾個 macro,它們會從位址中切出 index,或在 PTE 與 frame 的 physical address 之間轉換:
#define PGSHIFT 12   // bits of offset within a page#define PXMASK          0x1FF // 9 bits#define PXSHIFT(level) (PGSHIFT + (9 * (level)))#define PX(level, va)  ((((uint64)(va)) >> PXSHIFT(level)) & PXMASK)
#define PTE2PA(pte) (((pte) >> 10) << 12)#define PA2PTE(pa) ((((uint64)pa) >> 12) << 10)
一個 pte_t 存放一個 64 bit 的 entry,而 pagetable_t 指向一個由 512 個 entry 組成的表格。walk() 沿著兩個表格指標往下走,回傳 va 對應的 level-0 PTE 的位址,這個 PTE 可能仍是 invalid。它不檢查存取是否被允許:那是程式執行時 MMU 的工作。你會在 Lab 2 用到 walk()。
pte_t *
walk(pagetable_t pagetable, uint64 va, int alloc)
{
  if (va >= MAXVA)
    panic("walk");
  for (int level = 2; level > 0; level--) {    pte_t *pte = &pagetable[PX(level, va)];    if (*pte & PTE_V) {
      pagetable = (pagetable_t)PTE2PA(*pte);    } else {
      if (!alloc || (pagetable = (pde_t *)kalloc()) == 0)
        return 0;  // kalloc() returns 0 if all physical frames have been consumed
      memset(pagetable, 0, PGSIZE);
      *pte = PA2PTE(pagetable) | PTE_V;
    }
  }
  return &pagetable[PX(0, va)];
}
PXMASK是 511(0x1FF),也就是九個 1:PX(level, va)把va右移,保留該層 index 的 9 個 bit。PTE2PA丟掉 PTE 的 10 個 flag bit,再補上 12 個 0 bit,把 frame number 變成 frame 的 physical address。PA2PTE則反過來。- 當 entry 不存在而
alloc不為 0 時,walk()會用kalloc()取得一個空閒的 page(沒有剩餘時回傳 0),用memset()清成 0,再讓 entry 指向它並設定PTE_V。 MAXVA= 238 是 xv6 使用的位址上限。
0x404044 經過三層轉換,bit、表格和 walk() 並排對照。最後還有三個出錯的存取。
開啟 Walkthrough 3 ▶ 15 步 · 用 ← → 鍵切換 · 按 E 看說明
Segmentation Fault 😵 ‼️
每次存取時,MMU 都會檢查它走到的 PTE。如果這個 entry 是 invalid,或它的 bit 不允許這次存取,MMU 就會擋下這次存取,並引發 page fault。在 Linux 上,透過 NULL pointer 讀取時,找不到有效的 entry。寫入 W = 0 的 page,或在 user mode 存取 U = 0 的 page,都不被允許。page fault 會把控制權交給 kernel。如果程式無權進行這次存取,Linux 會送給它 SIGSEGV 這個 signal,預設會結束程式,shell 通常會印出 Segmentation fault (core dumped)。(不是每個 page fault 都是 bug。有些 kernel 會修好,程式就繼續執行。)
位址 0 就是 NULL。預設情況下,Linux 讓每個 process 最低的 64 KiB 都不做 mapping(我的電腦上 /proc/sys/vm/mmap_min_addr 是 65536),所以 dereference NULL pointer 會觸發 fault,而不是讀到錯誤的東西。
2009 年,Google 的研究人員展示了一個 NULL pointer 如何讓任何使用者在世界上幾乎每一台 Linux 機器上取得 root 權限。攻擊者的程式把自己的程式碼放在位址 0,接著發出一個 system call,觸及一個沒有人填入的 kernel function pointer。kernel 呼叫了 NULL,跳到位址 0,以最高權限執行了攻擊者的程式碼。這個 bug 已經修好,而且現在 Linux 也禁止一般程式 mapping 最低的那些 page,因此 kernel 中的 NULL 會改為觸發 fault。
資料來源:LWN, "Linux NULL pointer dereference due to incorrect proto_ops initializations", 2009; Linux mm/Kconfig.
把它弄爆
下一個 walkthrough 的每一步都展示一種情況,名稱標在最上方:先是兩個成功的存取,接著四個失敗的存取,每個都附上決定結果的 PTE bit。
counter 的 page 進行讀取、寫入和執行,同時 kernel 每次清除它 PTE 中的一個 bit。每次存取都會顯示 MMU 的三項檢查。過程中請先猜猜結果。
開啟 Walkthrough 4 ▶ 9 步 · 用 ← → 鍵切換 · 按 E 看說明
A 與 D:由硬體設定的 bit
V、R、W、X、U 由 kernel 設定。最後兩個 bit 則反過來:page 被存取時由硬體打開 A,被寫入時打開 D,再由 kernel 把它們清掉。(Lab 2 使用的機器 QEMU 就是這樣運作。RISC-V 標準也允許 CPU 改為引發 fault,交由 kernel 設定這些 bit。)kernel 先清除這些 bit,過一陣子再回來看,就能得知兩件原本看不到的事。
- 哪些 page 最近被使用過?這就是 A bit。RAM 不夠用時,kernel 傾向先移出一段時間沒被使用的 page。
- 哪些 page 被寫入過?這就是 D bit。只有 dirty 的 page 需要寫回磁碟。在 Lab 2 中,你會利用 D 只複製被寫入過的 page,來保存程式記憶體的 snapshot。
Part 6TLB:位址轉換的 cache
這棵樹是有代價的。當 cache 裡沒有現成的轉換結果時,一個 load 要先讀三個 PTE(每一層一個),然後才讀得到資料:原本只要一次記憶體讀取,現在要四次。同樣的答案一再被用到時,解法一向都一樣:把它們 cache 起來。
TLB(translation lookaside buffer)是 CPU 裡面的一個小 cache。每個 entry 記住一筆最近用過的轉換:一個 virtual page number、它的 frame number,以及它的 flag 位元。每次存取記憶體時,MMU 都會先查 TLB。
- TLB hit:轉換結果馬上就有,完全不必讀 page table。
- TLB miss:MMU 做一次 page walk(在 Sv39 要讀 3 次),再把結果存進 TLB,取代一個舊的 entry。
TLB 只有幾十個 entry 卻夠用,是因為一個 entry 就涵蓋了一整個 page。在一個對齊 page 邊界、由 4-byte int 組成的陣列裡,相鄰的 1024 個元素共用同一筆轉換。逐一走過它們的迴圈只在第一個元素 miss,之後只要這個 entry 還留在 TLB 裡,其餘 1023 個都會 hit。這就是 locality(區域性),也是每一種 cache 能發揮作用的原因。
TLB 一次最多能涵蓋的記憶體量,叫做它的 reach:entry 數 × page 大小。在我的電腦的 CPU 上,每個效能核心都有一個第一層 TLB,給 4 KiB page 用的 entry 有 64 個,reach 是 256 KiB;它後面還有一個第二層 TLB,約 2048 個 entry,大約 8 MiB。(這裡說的 TLB 層級是 cache 的層級,不是 page table 的層級。)如果程式一直輪流存取比 TLB 容納得下還多的 page,就會經常 miss,即使其他什麼都沒變,程式也會變慢。
位址轉換 cache 的兩個問題
1. Context switch。同一個 virtual page number 在 process A 和 process B 裡對應到不同的 frame。從 A 切換到 B 之後,MMU 不能把 A 的轉換拿給 B 用。xv6 的解法是每次切換 page table 時都 flush TLB,把所有 entry 全部丟掉。於是新的 process 一開始到處都是 miss。
比較好的做法是替每個 TLB entry 加上一個 address-space ID(ASID)標籤。這樣好幾個 process 的 entry 就能同時留在 TLB 裡,MMU 只使用標籤和目前執行中的 process 相符的那些。
2. Page table 被改了。TLB 存的是少數幾個 PTE 的副本,kernel 修改 PTE 時,沒有任何機制會自動更新這些副本。假設 kernel 清掉 W,要把一個 page 改成唯讀。如果舊的、可寫的轉換還留在 TLB 裡,下一次寫入就可能照樣通過,好像什麼事都沒發生。所以 kernel 修改 PTE 之後,必須把 TLB 裡過時的 entry flush 掉。
開啟 Walkthrough 5 ▶ 共 14 步 · 用 ← → 鍵切換 · 按 E 看說明
Part 7page 該多大?
為什麼 page 是 4 KiB?其實它可以更大。這個選擇是一種取捨。
| 小 page | 大 page | |
|---|---|---|
| TLB reach | 小:miss 較多 | 大:miss 較少 |
| Page table 大小 | entry 較多 | entry 較少 |
| 最後一個 page 內的浪費 | 很少 | 很多 |
| 能有自己的權限、或被整塊複製的最小區域 | 小 | 大 |
大多數 CPU 都讓 kernel 混用不同大小的 page。在 Sv39 裡,page walk 可以提早結束:一個 valid 的 level-1 entry 只要設了 R 或 X,本身就是 leaf,對應一整個 2 MiB 的 huge page;位在 level 2 的 leaf 則對應 1 GiB。轉換一個 2 MiB page 只要讀兩個 PTE,而不是三個。
一個 2 MiB page 的 TLB entry 涵蓋的記憶體,和 512 個 4 KiB page 的 entry 一樣多。代價在於配置:一個 2 MiB page 需要一整塊連續的 2 MiB 實體 RAM,而且它的 virtual address 和 physical address 都必須是 2 MiB 的倍數。它的權限也是整個 2 MiB 一起設定。下面的量測在完全相同的存取上比較這兩種大小。
總結:2 MiB page 需要的 page table 查詢比 4 KiB page 少,所以讀取比較快。代價是更多的 internal fragmentation:一個只用到 huge page 一部分的區域,會浪費掉剩下的空間,最多將近 2 MiB;而 4 KiB page 浪費的不到 4 KiB。
Android 15 開始支援使用 16 KB page 的手機。在 TLB entry 數量相同的情況下,16 KB page 涵蓋的記憶體是 4 KB page 的四倍,page table 需要的 entry 也比較少。代價是沒填滿的 page 裡會有更多用不到的空間。在 Google 的測試中,記憶體吃緊時 app 的啟動時間平均縮短了 3.16%;實際結果依手機和 app 而異。
Google Play 現在要求以 Android 15 以上為目標版本、在 64 位元裝置上執行的 app 支援 16 KB:從 2027 年 2 月 1 日起,沒有支援的 app 更新將無法發布。
自我檢查學習目標
不看學習單也能做到的項目,就把它打勾。下一次小考會考這些主題。(進度只儲存在這個瀏覽器裡。)
出處致謝
- 課程插圖中的 Nini 和 Niko 是清大資工作業系統課程的教材(Tony Chen / Yun-Chih Chen),以 CC BY 4.0 授權。貓咪圖案來自 Freepik 和 ChatGPT。貓咪徽章是從課程的
cat-right.png裁切下來的,本週的新圖片則是用 Google Gemini 以這些圖案為基礎生成;詳見images/CREDITS.md。 - xv6 程式碼節錄自 xv6-riscv(MIT 授權),和課程 Lab 2 使用的版本相同。
- 所有測量都在同一台 Linux 6.8 機器(Intel Core i9-13900KF)上完成。